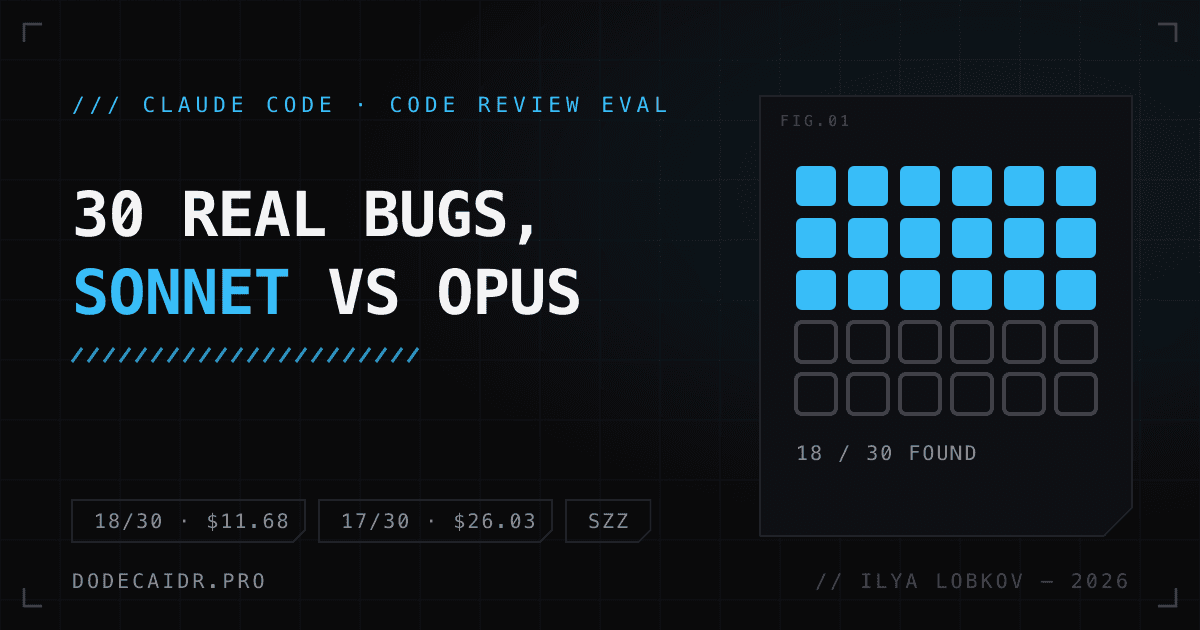
上一篇文章里,我把提交审查从 Opus 换成了 Sonnet,费用降了 62%。但还有一个问题没答案:这样换会漏掉多少 Bug。没有标准答案就没法回答,所以我从自己仓库的历史里搭了一套 AI 代码审查的测试集:18 个提交,里面藏着 30 个后来被手动修复的 Bug。然后用同一个审查脚本,分两种模式跑了一遍。
Sonnet 找出 30 个里的 18 个,花了 $11.68。Opus 找出 17 个,花了 $26.03。
要点:
- 在这套数据上,Opus 并没有找得更多。30 个 Bug 里差一个说明不了什么,但目前也看不出多付一倍的理由。
- 两个模型漏掉的并不一样。合起来能找到 21 个,单独各 17 到 18 个。
- 两个模型都漏掉的 9 个 Bug 里,有 2 个用
tsc就能抓到,免费,几秒钟。 - 其余漏报很相似:Bug 要结合 diff 之外的文件才看得出来,或者要知道某个库在运行时的实际行为。
- 自动挖出来的候选里,有一半根本不是 Bug。不做人工标注,测试集就会说谎。
哪里能找到有标准答案的 Bug#
AI 审查工具的厂商都是自己给自己打分。DeepSource 说得很直白:每家都在自己的数据集上跑基准测试,然后自己赢下来。我想知道的是:它在我的脚本、我的代码上表现如何。
现成的数据源就在 git 里。每个提交信息里带 fix 的提交,改的都是以前某人写下的代码行。对这些行在修复前的状态跑 git blame,就能找到引入 Bug 的那个提交。这个方法叫 SZZ,取自 2005 年那篇论文三位作者的姓:Śliwerski、Zimmermann、Zeller。
git show -U0 --format= "$FIX" -- "$FILE" | grep '^@@'
git blame --porcelain -L 41,41 "$FIX^" -- "$FILE" | head -1
我用 Python 脚本扫了七个仓库:两个 Next.js 网站、一个用 Prisma 做数据库的目录站、一个网页计算器、一个用 TypeScript 写的开源 wiki,以及一个 iOS 应用和一个 Apple Watch 应用(都用 Swift)。一共得到 125 组“引入 Bug 的提交 → 修复提交”。
接下来是人工活。我剔除了只改数据和文案的修复,留下 37 个改动了代码的候选。每个候选由一个 Sonnet 智能体单独标注:读修复和原提交,回答三个问题。这是真正的缺陷,还是新需求?缺陷确实出在这个提交里吗?一个细心的审查者,不在真机上运行,能看出来吗?含多个 Bug 的案例,我自己又复核了一遍。
37 个标注完的候选里只剩下 18 个。这一轮筛选比我预想的更有价值:
- 一部分“修复”其实是在实现新需求,比如跨设备同步主题;
- 一部分的 Bug 出在另一个提交里,SZZ 指向的是恰好改了同几行的邻居;
- 一部分的缺陷是后来才暴露的,提交当时还没有触发它的数据。
还有一个细节,不处理的话数字就没有意义。如果把带完整历史的工作副本交给审查者,git log --all 会直接把未来的修复和 Bug 描述展示出来。所以每个案例我都单独建了一个只有两个提交的仓库:Bug 出现前的状态,加上带 Bug 的那个提交。里面没有未来。
测试方法#
审查用的是我每天都在用的 change-review。我给它加了三个参数:仓库位置、审查限定的文件范围、不写入状态。模式有两种:
| 模式 | 侦察 | 找问题与验证 |
|---|---|---|
| 普通 | Haiku | Sonnet |
thorough | Haiku | Opus |
审查结束后,由另一个评判智能体把发现的问题和标准答案对照:原因相同、故障相同即算命中,行号可以不同。没对上标准答案的发现,评判智能体会再查代码,标出是不是真缺陷。
AI 代码审查的结果#
| Sonnet | Opus | |
|---|---|---|
| 30 个里找到 | 18 | 17 |
| high,共 14 个 | 9 | 9 |
| medium,共 10 个 | 7 | 6 |
| low,共 6 个 | 2 | 2 |
| 至少命中一个标准答案的案例 | 18 个里 10 个 | 18 个里 11 个 |
| 多报的问题数,其中评判认定为真缺陷的 | 77 / 57 | 75 / 57 |
| 按 API 价目表计的审查费用 | $11.68 | $26.03 |
| 单个案例费用 | $0.65 | $1.45 |
费用按智能体日志里的 message.usage 计算,方法和上一篇一样。评判智能体另花了 $1.63 和 $1.70,标准答案的标注花了 $3.94。整个实验大约 $45。
14 个严重 Bug 里,两个模型各找到 9 个,但不是同一批。Opus 抓到了一个付费墙:它向已经用过试用期的订阅用户承诺试用。要看出这点,得知道 StoreKit 里享受入门优惠的资格是和优惠本身分开校验的。Sonnet 抓到了 wiki 的首次初始化:任何访问全新服务器的人都能走完流程,成为管理员。总计 Sonnet 有 4 个 Opus 没找到的 Bug,Opus 有 3 个 Sonnet 没找到的。
两个模型各跑一遍,合起来找到 21 个,比任何单个都多。两次一起花了 $37.71,比单跑 Opus 还贵。更便宜的办法是让 Sonnet 跑两遍,大约 $23,不过这个组合我没有实际跑过。还有一个保留:每种模式我只跑了一次。一部分差异可能只是同一个模型多次运行之间的波动,这一点我还没测。
谁都没找到的 Bug#
两个模型都漏掉了 9 个 Bug,分三类。
类型错误。 计算器里有个函数调用时少传了必填参数 weight;另一个文件用了一个没有任何地方声明过的类型 IntlMessages。这两个提交的构建都是失败的。审查者在同样的文件里找出了 6 到 10 个别的问题,偏偏漏了这两个。tsc --noEmit 不花一个 token 就能找到。所以顺序应该是:先跑编译器、测试和 linter,最后才轮到模型。
Bug 在与另一个文件的衔接处。 有三例:
- CSP 里去掉了
'unsafe-eval',而客户端执行 MDX 用的是new Function(),结果文章在线上直接报错; serialize()在 dev 模式下把 MDX 编译成了一种 JSX 运行时,而之后渲染它的是另一种;- 站点地图在构建 Docker 镜像时预渲染,而镜像里没有数据库,于是连续六小时返回空列表。
每次 diff 里只有一个文件,单看它没有问题。要发现 Bug,得打开用到这个配置的组件,或者知道代码到底在哪里执行。审查者有权读周围的代码,但面对受限的 diff,它并不会这么做。这和我上次写到的盲区是同一个:逐个文件做增量检查,看不到文件之间的联系。
小问题。 三个 low 级别、本身还有争议的 Bug,另有一个针对 slug === "test" 的特例,它的含义只在同一提交的信息里解释过。
一次评测要花多少#
两次运行合计消耗约 6400 万 token。其中 82% 到 85% 是缓存读取,价格是普通输入的二十分之一。机制和上一篇相同:每个智能体启动时带着约 4.9 万 token 的上下文,每次请求都要把它重新读一遍。18 个案例,每种模式大约 130 个智能体。
这 4.9 万里有相当一部分和任务无关:CLAUDE.md 里的通用规则,以及我启动评测的那个项目的记忆。智能体审查的是别的仓库,却带着我网站的规则。所以其中一次检查甚至在旧提交里找出了一条助手署名,而这恰恰是我自己的规则禁止的。
我会怎么改#
- 普通模式继续用 Sonnet。 目前没有数据支持在审查里用 Opus。
thorough留给发布前,作为普通模式之后的第二次独立运行。 - 审查之前先跑
tsc和构建。 九个漏报里有两个可以免费解决。 - 给审查者提供使用了被改代码的文件。 现在只给它 diff。调用方列表在启动模型之前用 grep 就能找出来。
- 标准答案现在和脚本放在一起。 每次改审查提示词,都能在同样的 18 个案例上重跑,看效果变好还是变差。
我没验证的#
- 多次运行之间的波动。 每种模式只跑了一次。要说“模型漏掉的不一样”,而不是“某一次运行漏掉的不一样”,每种模式至少要跑三遍。
- 标准答案是 Sonnet 标注的。 含多个 Bug 的案例我复核过,但不是全部。如果标注者漏掉了某个提交里的 Bug,它就不在标准答案里,审查者的发现会被算进“多报”。
- 评判也是 Sonnet,而且是低强度设置。它对多报问题的判断(77 个里有 57 个是真的)我没有手动核对。
- 30 个 Bug 太少。 在这样的数据集上,两种模式相差不到 3 到 4 个 Bug,都算噪声。
如果你也有自己的审查脚本,从一个晚上开始:对历史跑 SZZ,人工标注,把案例隔离成独立仓库。没有这些,任何“新模型审查得更好”都只是看法,不是测量。workflow 脚本本身是怎么搭的,我在 Claude Code workflows 那篇里讲过。它们的 token 消耗从哪来,见 Claude Code 的 token 消耗。