В прошлой статье я перевёл ревью коммитов с Opus на Sonnet и срезал цену на 62 %. Открытым остался один вопрос: сколько багов при этом теряется. Ответить на него без эталона нельзя, поэтому я собрал эталон для AI код-ревью из истории собственных репозиториев: 18 коммитов, в которых сидят 30 багов, позже исправленных вручную. Прогнал на них один и тот же скрипт ревью в двух режимах.
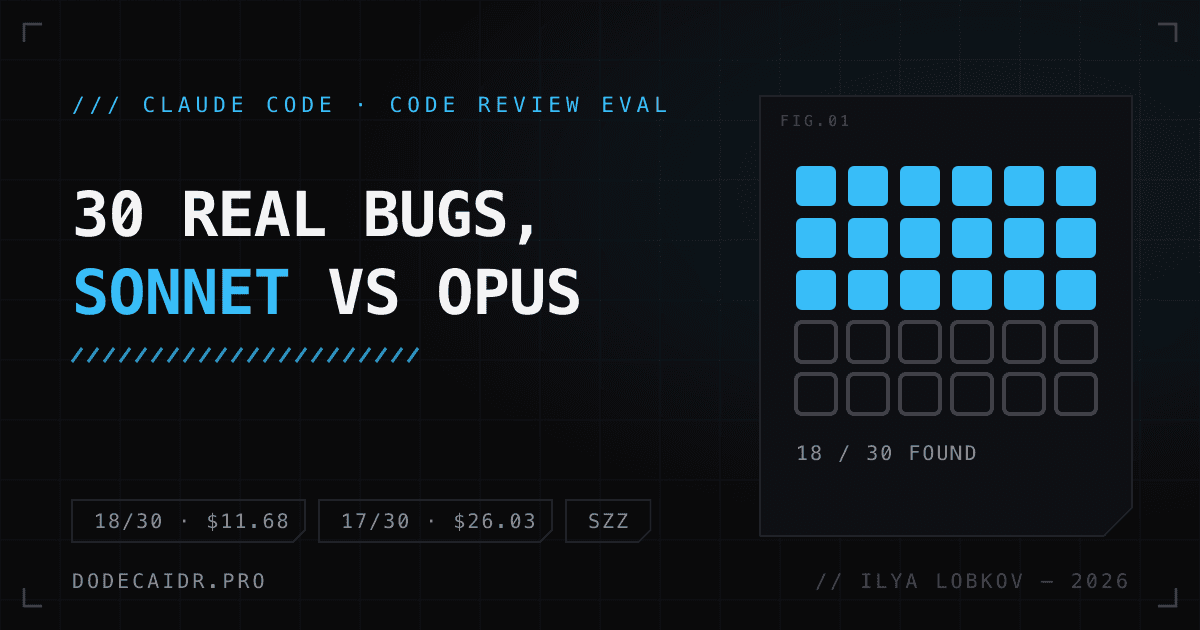
Sonnet нашёл 18 багов из 30 за $11,68. Opus нашёл 17 за $26,03.
Главное:
- Opus в этом наборе не нашёл больше. На 30 багах разница в один баг ничего не значит, но и платить вдвое больше пока не за что.
- Модели пропустили разное. Вместе они нашли 21 баг, каждая по отдельности 17–18.
- Два из девяти пропущенных обоими багов ловит
tsc. Бесплатно и за секунды. - Остальные пропуски похожи друг на друга: баг виден только вместе с файлом, которого нет в диффе, или со знанием того, как библиотека ведёт себя в рантайме.
- Половина кандидатов, которых нашёл автоматический поиск, оказалась не багами. Без ручной разметки эталон врёт.
Откуда взять баги с известным ответом#
Вендоры AI-ревью меряют себя сами. В DeepSource это сформулировали прямо: каждый гоняет бенчмарк на своём наборе данных и сам же в нём побеждает. Мне нужен был ответ про мои скрипты и мой код.
Готовый источник лежит в git. Каждый коммит с fix в сообщении правит строки, которые когда-то кто-то написал. git blame по этим строкам в состоянии до фикса показывает коммит, где баг появился. Этот приём называется SZZ, по фамилиям авторов статьи 2005 года: Śliwerski, Zimmermann, Zeller.
git show -U0 --format= "$FIX" -- "$FILE" | grep '^@@'
git blame --porcelain -L 41,41 "$FIX^" -- "$FILE" | head -1
Скрипт на Python прошёл по семи репозиториям: два сайта на Next.js, каталог с базой на Prisma, веб-калькулятор, open-source вики на TypeScript, iOS-приложение и приложение для Apple Watch на Swift. Он нашёл 125 пар «коммит с багом → фикс».
Дальше ручная работа. Я отбросил фиксы данных и текстов и оставил 37 кандидатов с правками кода. Каждого разметил отдельный агент на Sonnet: прочитал фикс и исходный коммит и ответил на три вопроса. Это настоящий дефект, а не новое требование? Он есть в этом коммите? Мог ли его заметить внимательный ревьюер без запуска на устройстве? Кейсы с несколькими багами я перепроверил сам.
Из 37 размеченных осталось 18. Отсев оказался полезнее, чем казалось:
- часть «фиксов» реализовала новое требование, например синхронизацию темы между устройствами;
- в части баг появился в другом коммите, а SZZ указал на соседний, который просто трогал те же строки;
- в части дефект проявился позже, на данных, которых в момент коммита ещё не было.
Ещё одна деталь, без которой цифры ничего не стоят. Если ревьюеру дать рабочую копию с полной историей, git log --all покажет будущий фикс вместе с описанием бага. Поэтому каждый кейс я собрал в отдельный репозиторий из двух коммитов: состояние до бага и сам коммит с багом. Будущего в нём нет.
Как проверял#
Ревью делал тот же change-review, что работает у меня каждый день. Я добавил ему три аргумента: где лежит репозиторий, какими файлами ограничить ревью и не писать состояние. Режимы два:
| Режим | Разведка | Поиск и проверка находок |
|---|---|---|
| обычный | Haiku | Sonnet |
thorough | Haiku | Opus |
После ревью отдельный агент-судья сравнивал находки с эталоном: та же причина и тот же сбой, номер строки может отличаться. Находки, не совпавшие с эталоном, судья проверял по коду и отмечал, настоящий ли это дефект.
Результаты AI код-ревью#
| Sonnet | Opus | |
|---|---|---|
| Найдено из 30 | 18 | 17 |
| high, из 14 | 9 | 9 |
| medium, из 10 | 7 | 6 |
| low, из 6 | 2 | 2 |
| Кейсов хотя бы с одной находкой из эталона | 10 из 18 | 11 из 18 |
| Лишних находок, из них настоящих по судье | 77 / 57 | 75 / 57 |
| Цена ревью по прайсу API | $11,68 | $26,03 |
| Цена на кейс | $0,65 | $1,45 |
Цены считал по message.usage из журналов агентов, как в прошлой статье. Судья обошёлся ещё в $1,63 и $1,70, разметка эталона в $3,94. Весь эксперимент стоил около $45.
Из 14 серьёзных багов обе модели нашли по девять, но не одни и те же. Opus поймал paywall, который обещает пробный период подписчику, уже его использовавшему. Для этого надо знать, что в StoreKit право на вводное предложение проверяется отдельно от самого предложения. Sonnet поймал первичную настройку вики, которую мог пройти любой посетитель свежего сервера и стать администратором. Всего у Sonnet четыре бага, которых нет у Opus, у Opus три, которых нет у Sonnet.
Два прогона разными моделями вместе нашли 21 баг, больше любого из них по отдельности. Стоят они $37,71, дороже одного Opus. Дешевле было бы запустить Sonnet дважды, примерно за $23, но такой прогон я не делал. Есть и оговорка: каждый режим я запускал один раз. Часть разницы может оказаться разбросом между запусками одной и той же модели, и это я пока не измерил.
Что не нашёл никто#
Девять багов пропустили обе модели. Они делятся на три группы.
Ошибки типов. В калькуляторе функция вызывается без обязательного параметра weight, в другом файле используется тип IntlMessages, который нигде не объявлен. На обоих коммитах падала сборка. Ревьюеры при этом нашли в тех же файлах по 6–10 других проблем, но именно эти две пропустили. tsc --noEmit находит такое без единого токена. Отсюда порядок: сначала компилятор, тесты и линтер, и только потом модель.
Баг живёт на стыке с другим файлом. Три случая:
- из CSP убрали
'unsafe-eval', а MDX на клиенте исполняется черезnew Function(), и статьи падают в проде; serialize()компилирует MDX в dev-режиме под другой JSX-рантайм, чем тот, которым его потом рендерят;- карта сайта пререндерится при сборке Docker-образа, где нет базы, и отдаёт пустой список шесть часов подряд.
В диффе каждый раз один файл, и сам по себе он выглядит нормально. Чтобы увидеть баг, надо открыть компонент, который этот конфиг использует, или знать, где выполняется код. Ревьюер имеет право читать окружающий код, но на ограниченном диффе этого не делает. Это та же слепая зона, о которой я писал в прошлый раз: инкрементальный проход по одному файлу не видит связей между файлами.
Мелочи. Три бага уровня low, о которых можно спорить, и одно исключение для slug === "test", смысл которого объяснён только в сообщении того же коммита.
Сколько стоит одна оценка#
Оба прогона вместе съели около 64 млн токенов. 82–85 % из них — это чтение кэша, которое стоит в двадцать раз дешевле обычного входа. Механика та же, что в прошлой статье. Каждый агент стартует с контекстом примерно в 49 тыс. токенов, и запросы перечитывают его снова и снова. На 18 кейсов это около 130 агентов на режим.
Значительная часть этих 49 тысяч не имеет отношения к задаче: общие правила из CLAUDE.md и память проекта, из которого я запускал оценку. Агенты ревьюили чужие репозитории, но несли с собой правила моего сайта. Поэтому одна из проверок даже нашла в старом коммите подпись ассистента, запрещённую моими же правилами.
Что я поменяю#
- Обычный режим остаётся на Sonnet. Данных за Opus в ревью нет.
thoroughостанется для релизов вторым, независимым прогоном после обычного. - Перед ревью —
tscи сборка. Два из девяти пропусков закрываются бесплатно. - Ревьюеру — файлы, которые используют изменённый код. Сейчас ему дают только дифф. Список вызывающих находится grep'ом до запуска модели.
- Эталон теперь лежит рядом со скриптами. Любую правку промпта ревью можно прогнать на тех же 18 кейсах и увидеть, стало лучше или хуже.
Чего я не проверил#
- Разброс между запусками. Каждый режим я запускал один раз. Чтобы сказать «модели пропускают разное», а не «один запуск пропустил разное», нужно хотя бы три прогона на режим.
- Эталон размечал Sonnet. Я перепроверил кейсы с несколькими багами, но не все. Если разметчик пропустил баг в коммите, он не попал в эталон, и находка ревьюера ушла в «лишние».
- Судья тоже Sonnet, с низким уровнем усилия. Его оценку лишних находок (57 настоящих из 77) я руками не проверял.
- 30 багов мало. Разница меньше 3–4 багов между режимами на таком наборе — шум.
Если у вас есть свои скрипты ревью, начните с одного вечера: SZZ по истории, ручная разметка, изолированные кейсы. Без этого любое «новая модель ревьюит лучше» — мнение, а не замер. Как устроены сами workflow-скрипты, я разбирал в статье про Claude Code workflows. Откуда в них берётся расход токенов, рассказывал в статье про расход токенов Claude Code.